

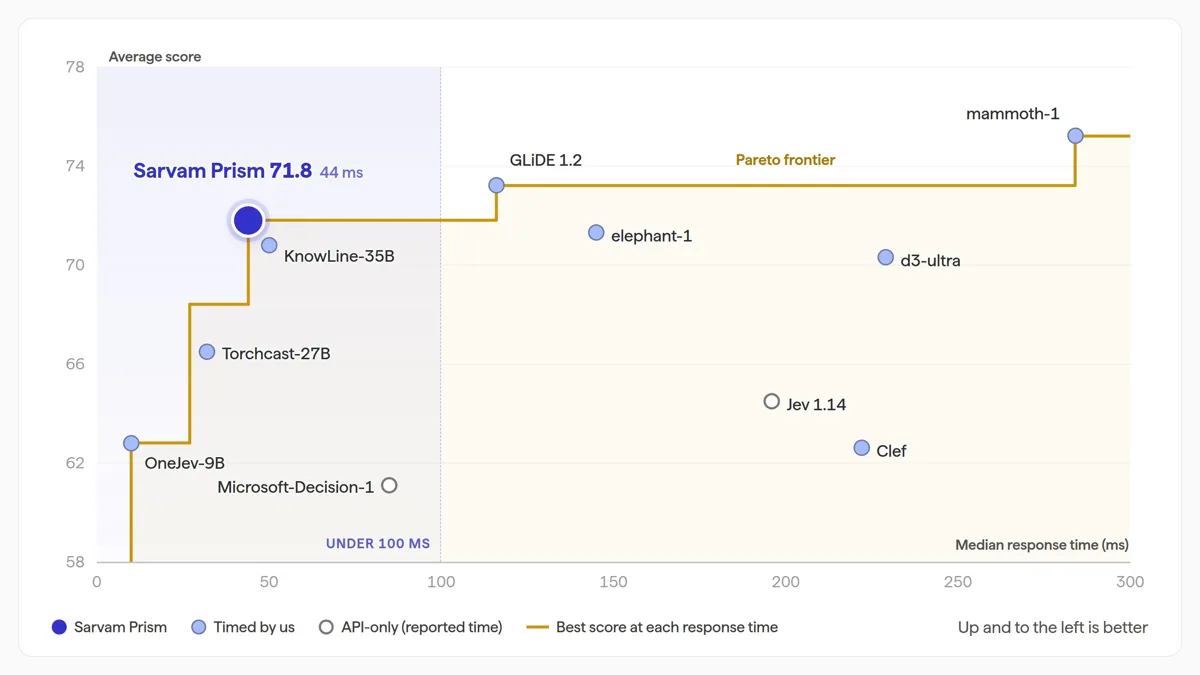
बेंगलुरु की AI कंपनी Sarvam AI ने 3 नवंबर 2026 की शाम अपना नया मॉडल Sarvam Prism लॉन्च किया है। यह कोई चैटबॉट नहीं, बल्कि एक “डिसीजन मॉडल” है, जो किसी सवाल के सामने रखे गए विकल्पों में से हर विकल्प के सही होने की संभावना (प्रोबेबिलिटी) सिर्फ एक बार में बता देता है। कंपनी के मुताबिक Prism का जवाब औसतन 44 मिलीसेकंड में आता है और 100 मिलीसेकंड से कम समय लेने वाले 25 परखे गए डिसीजन मॉडलों में यह सबसे ज़्यादा स्कोर करने वाला मॉडल है। इसके वेट्स Apache 2.0 लाइसेंस के तहत ओपन हैं।
Sarvam Prism क्या है: एक नज़र में
| बिंदु | जानकारी |
|---|---|
| मॉडल का प्रकार | System One डिसीजन मॉडल (हर विकल्प के लिए कैलिब्रेटेड प्रोबेबिलिटी) |
| आधार मॉडल | Sarvam 105B (105B-10B MoE बेस) का LoRA फाइन-ट्यून |
| औसत स्कोर | 71.8 (तीन इंडेक्स का औसत) |
| मीडियन स्पीड | 44 ms, एक B200 GPU पर |
| कॉन्टेक्स्ट | 1,31,072 टोकन प्रति सवाल |
| लाइसेंस | Apache 2.0, वेट्स Hugging Face पर |
| हार्डवेयर | FP8 में कम से कम 120 GB मेमोरी वाला एक GPU |
| लॉन्च | 3 नवंबर 2026, Sarvam ब्लॉग और X पर |
पूरी तकनीकी जानकारी Sarvam के आधिकारिक ब्लॉग में दी गई है। यह खबर उसी ब्लॉग और कंपनी के आधिकारिक X पोस्ट पर आधारित है।

“System One” डिसीजन मॉडल का मतलब क्या है
मनोवैज्ञानिक डैनियल काह्नमैन ने इंसानी सोच को दो हिस्सों में बांटा था: System One, यानी तेज़ और सहज फैसले, और System Two, यानी धीमी और गहरी सोच। Sarvam का कहना है कि किसी कंपनी का ज़्यादातर रोज़ का काम ऐसे ही छोटे-छोटे तेज़ फैसलों की कड़ी होता है, जैसे कोई टिकट किस टीम को जाए, कोई ट्रांज़ैक्शन संदिग्ध है या नहीं, या किसी AI एजेंट का काम सफल हुआ या नहीं। ब्लॉग के अनुसार यह कैटेगरी पिछले महीने TypeSafe नाम की कंपनी ने अपने Jev मॉडल के साथ शुरू की थी।
Prism को सवाल, उससे जुड़ी स्थिति (स्टेट) और विकल्प दिए जाते हैं। मॉडल इन्हें एक ही फॉरवर्ड पास में पढ़ता है और एक छोटा स्कोरिंग हेड हर विकल्प के लिए प्रोबेबिलिटी लौटाता है। इसलिए जवाब के लिए लंबा टेक्स्ट लिखने की ज़रूरत नहीं पड़ती और स्पीड बहुत तेज़ रहती है।
बेंचमार्क: भारतीय भाषाओं में सबसे मज़बूत
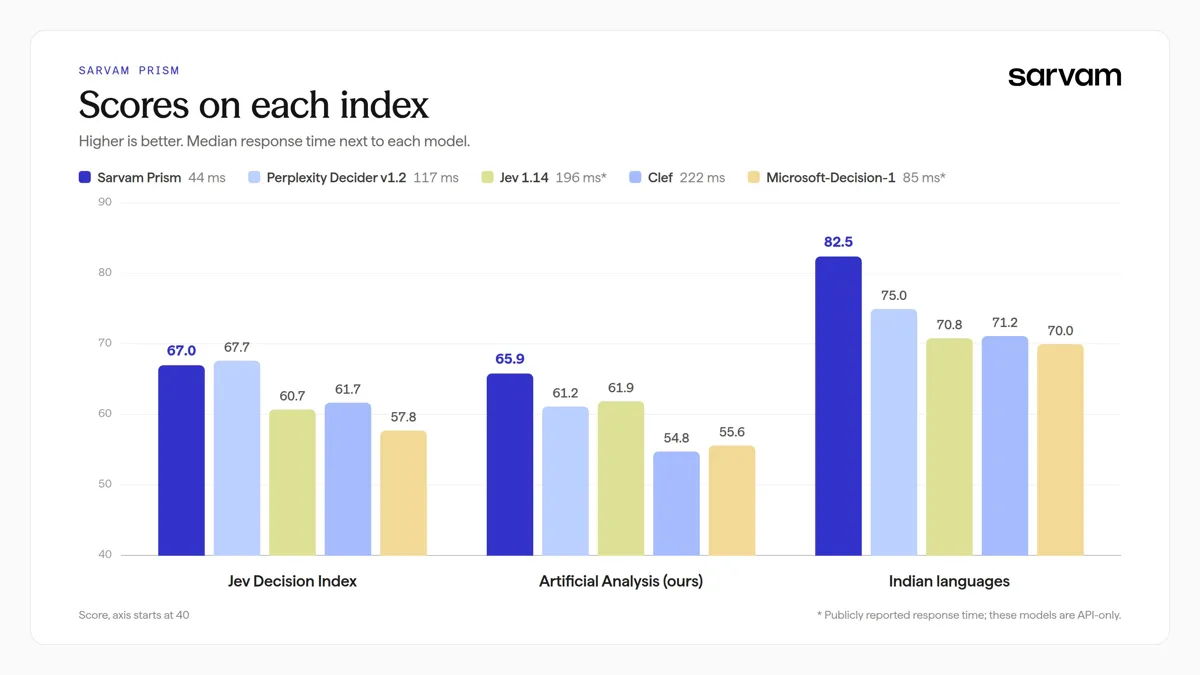
Sarvam ने Prism और 24 दूसरे डिसीजन मॉडलों को तीन इंडेक्स पर परखा। Prism के स्कोर नीचे हैं:
| इंडेक्स | Prism का स्कोर |
|---|---|
| Jev Decision Index | 67.0 |
| AA इंडेक्स | 65.9 |
| भारतीय भाषाएं | 82.5 |
| तीनों का औसत | 71.8 |
भरोसेमंद कॉन्फिडेंस (कैलिब्रेशन)
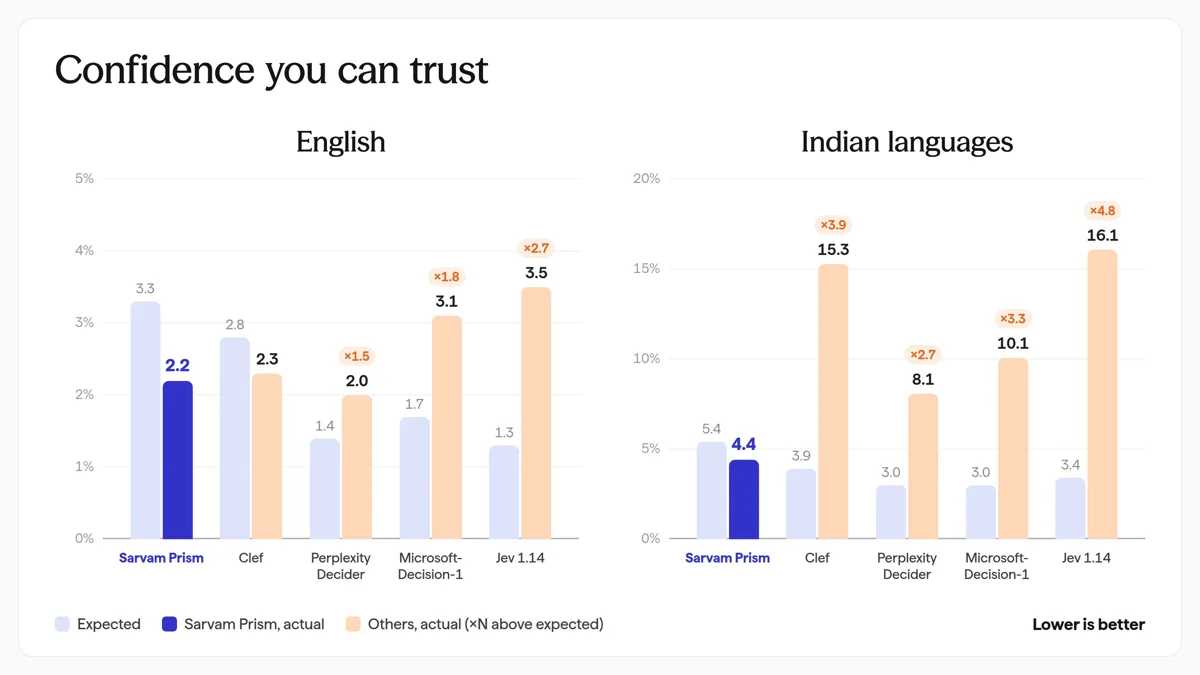
किसी काम को ऑटोमेट करने के लिए कंपनियों को यह भरोसा चाहिए कि मॉडल जब 90% या उससे ज़्यादा भरोसे से जवाब दे, तो उसकी गलती की दर भी उतनी ही कम हो। Sarvam के ब्लॉग के अनुसार अंग्रेज़ी में ऐसे जवाबों पर अपेक्षित गलती 3.3% थी जबकि असल गलती सिर्फ 2.2% रही। भारतीय भाषाओं में अपेक्षित 5.4% के मुकाबले असल गलती 4.4% रही। चार्ट में दिखाए गए दूसरे मॉडलों की असल गलती उनके अनुमान से 1.5 से 4.8 गुना तक ज़्यादा थी।
कंपनी ने एक और टेस्ट किया: 2,000 सवालों को चार बार विकल्पों का क्रम बदलकर और चार बार बिना बदले चलाया गया। ब्लॉग के मुताबिक विकल्पों का क्रम बदलने पर भी Prism का जवाब हर बार एक जैसा रहा।
AI एजेंटों के काम की जांच और साइबर सुरक्षा
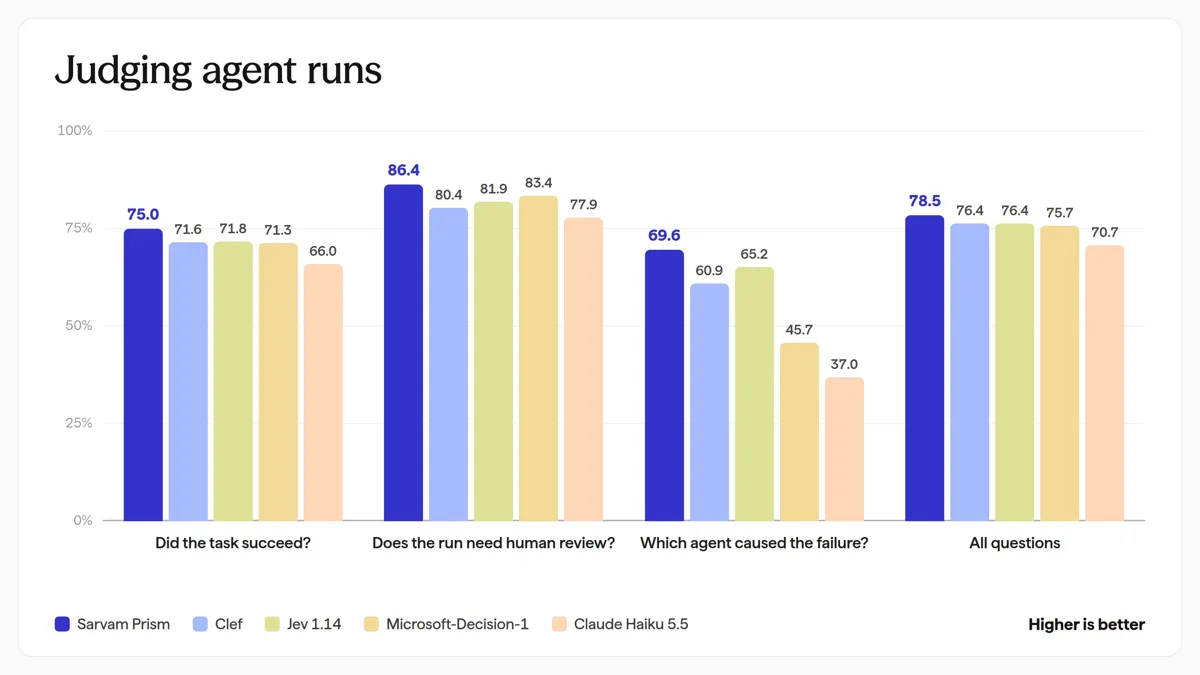
700 रिकॉर्ड किए गए AI एजेंट रन की जांच में Prism ने सभी सवालों पर 78.5% सटीकता दिखाई, जबकि Clef और Jev 1.14 ने 76.4%, Microsoft-Decision-1 ने 75.7% और Claude Haiku 5.5 ने 70.7% स्कोर किया। “कौन सा एजेंट गलती की वजह बना” वाले सवाल पर Prism ने 69.6% सही जवाब दिए। Sarvam के अनुसार Prism एक GPU पर पूरा एजेंट रन लगभग आधे सेकंड में जांच लेता है, जबकि API से Claude Haiku 5.5 को मीडियन 2.5 सेकंड लगते हैं और 1,000 रन पर करीब 0.64 डॉलर खर्च होते हैं।
कंपनी के अपने 5,517 सवालों वाले साइबर सुरक्षा बेंचमार्क पर Prism ने 89.0% सटीकता हासिल की। Clef ने 84.5%, Jev 1.14 ने 78.6% और Microsoft-Decision-1 ने 76.1% स्कोर किया। यह आंतरिक बेंचमार्क जुलाई 2026 के बाद सामने आई कमज़ोरियों से बना है।
664 ms से 44 ms तक: 15 गुना तेज़ कैसे हुआ
Prism शुरू में 16-बिट प्रिसिशन पर दो B200 GPU पर चलता था और एक रिक्वेस्ट में मीडियन 664 ms लगते थे। Sarvam ने वेट्स को FP8 में बदला ताकि मॉडल एक ही GPU पर आ जाए, अटेंशन की गणना को बेहतर बनाया और CUDA Graph जैसी तकनीकें इस्तेमाल कीं। कंपनी के मुताबिक इससे मॉडल करीब 15 गुना तेज़ हुआ और सटीकता नहीं घटी। FP8 से Jev इंडेक्स का स्कोर सिर्फ 0.01 अंक बदला।
डेवलपर और कंपनियां Prism कैसे इस्तेमाल करें
- मॉडल के वेट्स Hugging Face (sarvamai/prism) पर Apache 2.0 लाइसेंस में मुफ्त उपलब्ध हैं, यानी कंपनियां इसे अपने डेटा पर ट्रेन करके अपने सर्वर पर चला सकती हैं।
- जो खुद नहीं चलाना चाहते, उनके लिए Prism Sarvam API (Sarvam Indus) पर भी मौजूद है।
- हर रिक्वेस्ट में स्टेट, सवाल और विकल्प भेजे जाते हैं, और जवाब में हर विकल्प की प्रोबेबिलिटी मिलती है।
भारत में बने AI मॉडलों की दौड़ तेज़ हो रही है। इसी हफ्ते IndiaAI मिशन के तहत आए मॉडलों पर हमारी रिपोर्ट IndiaAI के EKA-1 और DHIR मॉडल भी पढ़ें।
अक्सर पूछे जाने वाले सवाल (FAQ)
Sarvam Prism क्या है?
Sarvam Prism, Sarvam AI का “System One” डिसीजन मॉडल है, जो दिए गए हर विकल्प के सही होने की कैलिब्रेटेड प्रोबेबिलिटी एक ही पास में बताता है। यह Sarvam 105B पर बना है।
Prism कितना तेज़ है?
कंपनी के अनुसार एक B200 GPU पर इसका मीडियन जवाब 44 मिलीसेकंड में आता है। 100 ms से कम वाले 25 परखे गए मॉडलों में इसका औसत स्कोर (71.8) सबसे ज़्यादा है।
क्या Sarvam Prism मुफ्त है?
इसके वेट्स Hugging Face पर Apache 2.0 लाइसेंस में खुले हैं। इसे चलाने के लिए कम से कम 120 GB मेमोरी वाला GPU चाहिए। API से इस्तेमाल के लिए Sarvam की शर्तें लागू होंगी।
क्या यह भारतीय भाषाओं में काम करता है?
हां। भारतीय भाषाओं के इंडेक्स पर Prism ने 82.5 स्कोर किया, जो इसके तीनों इंडेक्स में सबसे ऊंचा है।
स्रोत
- Sarvam AI ब्लॉग: Sarvam Prism: a decision model built on Sarvam 105B (3 नवंबर 2026)
- Hugging Face: sarvamai/prism
- Sarvam AI (@SarvamAI), आधिकारिक X पोस्ट, 3 नवंबर 2026
- तस्वीरें और चार्ट: Sarvam AI (आधिकारिक ब्लॉग/X); सभी बेंचमार्क आंकड़े कंपनी के अपने हैं


टिप्पणियाँ